「執行你自己的 AI 女友」這句話聽起來像一個程式。實際上,它是三個彼此溝通的部分,搞清楚哪個部分做什麼,可以省下大部分的挫折。
三個部分
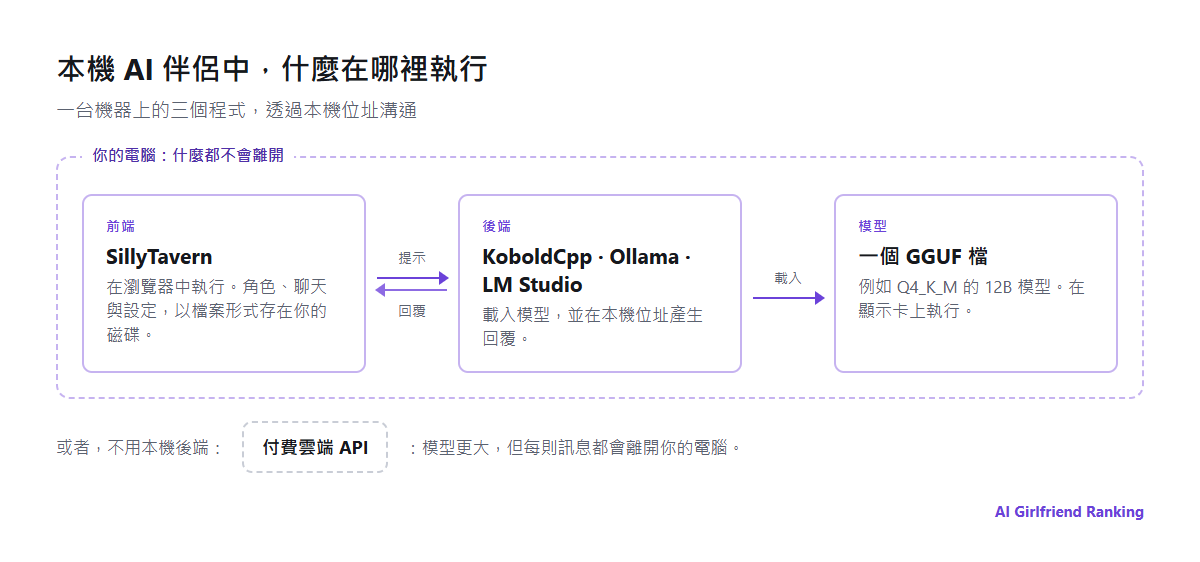
典型的本機架設中,誰和誰溝通。
前端是你看到的:聊天視窗、角色、虛擬形象、設定。SillyTavern 是角色聊天的標準選擇。它在你的瀏覽器中執行,把角色和聊天紀錄存成你磁碟上的檔案,幾乎能連接任何後端。它本身不產生文字。
後端負責載入模型並產生回覆。KoboldCpp 是一個不需安裝的單一程式,因為開放每一項生成設定而受角色扮演玩家歡迎。Ollama 是用幾行指令讓模型跑起來最簡單的方法。LM Studio 是有友善模型瀏覽器的桌面軟件。任何一個都會在本機位址提供模型,讓前端連線。
模型是一個大檔案,通常是 GGUF 格式,從 Hugging Face 下載。它以參數計算的大小,也就是 8B、12B、24B,以及量化方式,決定了它有多好、需要什麼硬件。
硬件問題
決定模型跑得好不好的是顯示記憶體(VRAM)。模型必須放得進去,還要留空間給對話本身。量化可以縮小模型以放進去:「Q4_K_M」是大小與質素之間常見的折衷。
| 模型大小 | Q4 約需記憶體 | 一般硬件 | 預期表現 |
|---|---|---|---|
| 7-8B | 5-6 GB | 8 GB 顯示卡 | 連貫、快速,長場景會忘記細節 |
| 12-14B | 9-10 GB | 12 GB 顯示卡 | 角色與文筆明顯更好 |
| 22-24B | 14-16 GB | 16-24 GB 顯示卡 | 角色扮演接近不錯的雲端軟件 |
| 70B | 40 GB 以上 | 兩張顯示卡或大記憶體 Mac | 極佳,但慢又貴 |
這些數字是粗略的:更長的上下文還需要額外的記憶體。Apple Silicon 的 Mac 在處理器與顯示之間共用記憶體,所以 32 GB 的 MacBook 可以跑 12 GB 顯示卡跑不動的模型。放不進去的模型會溢出到主處理器,速度慢到爬行。如果回覆每秒只出現幾個字,在嘗試更激進的量化之前,先換成較小的模型。質素良好的較小模型,通常勝過被壓得太狠的較大模型。
你得到什麼
- 不靠政策的私隱。什麼都不會離開你的機器。沒有保存期限、沒有訓練、沒有員工存取,之後也沒有東西要刪。
- 除了模型本身的限制,沒有其他過濾。你選擇模型,包括專門為角色扮演調校的。內容的法律底線仍然適用於你,但沒有業者在上面再加規則。
- 沒有訂閱,也沒有點數。想生成多少就生成多少。
- 你擁有的角色。角色卡就是嵌入角色設定的一般 PNG 圖片。它們可以在不同前端之間移動,更新也拿不走。
- 穩定。今天能用的模型,五年後的運作方式仍然一樣。沒有人能在你不知情時把它換掉,也就是AI 伴侶一夕之間改變時所描述的風險。
你得放棄什麼
- 設定時間。第一次能正常聊天要預留一個晚上,如果你樂在其中,還有幾週的調整。
- 記憶是你的工作。雲端軟件會悄悄摘要並儲存關於你的事實。在本機,你要用 SillyTavern 的知識庫、摘要和角色筆記來管理,也就是AI 伴侶的記憶如何運作裡說明的同樣三種機制,只是控制項都攤開在你面前。
- 圖片和語音是另外的專案。圖片生成需要自己的模型,通常需要更多顯示記憶體;語音需要語音辨識和合成工具。全都做得到,沒有一樣是自動的。
- 手機不方便。你可以在家用 Wi-Fi 下用手機開啟前端。要在外面使用,就得把你的電腦暴露到網絡上,需要小心處理。
- 質素天花板。最好的雲端模型,比多數人在家能跑的任何東西都大,特別是在長期一致性上。
折衷路線,以及它的缺點
許多人在自己的機器上執行 SillyTavern,卻把它連接到付費的雲端 API,而不是本機模型。你得到前端的控制和角色檔案、大得多的模型,以及輕度使用可能很便宜的按則計費。
不過它並不私密。每則訊息都會送到 API 供應商,受它的紀錄、保存和內容規則約束,這些規則對角色扮演內容常比專門的 AI 伴侶軟件更嚴格。這是不同的取捨,不是本機架設。
安全基本功
- 只從 GitHub 上的官方專案頁面或專案自己的網站下載軟件。
- 從 Hugging Face 上知名的上傳者下載模型,並優先選擇 GGUF 檔案,它們包含的是模型資料而不是程式碼。
- 閱讀模型的授權。有些限制商業使用,少數限制特定內容。
- 讓 SillyTavern 只綁定在你自己的機器或家用網絡,除非你已設定密碼,並了解自己暴露了什麼。
SillyTavern 在 GitHub 上公開開發。
適合誰
如果私隱是你的主要考量、你已經有夠強的硬件,或你享受設定東西不亞於使用它,就在本機執行 AI 伴侶。如果你想要語音、圖片和長記憶開箱即用,或主要用手機聊天,就留在雲端軟件。我們的挑選第一個軟件指南涵蓋那條路線。很多人最後兩者都用:雲端軟件圖方便,本機架設則用於他們不想儲存在其他地方的對話。